
给一句需求,CEO、产品、程序员、评审、测试几个 AI 角色在网页里分工、互相挑错,最后在本地文件夹里交出代码。这就是 ChatDev 2.0。2.0 版多了可视化工作流画布:每个角色是一个节点,可以拖拽、改提示词、换模型,编排自己的多智能体团队。
本篇在本机从源码跑通,全程接本地 Ollama 的 qwen2.5:7b,没花一分钱 API 费。需求是「网页版贪吃蛇」。实测结论先说:多角色真的在对话、代码真的落盘、小游戏能在浏览器打开并操作;但 7B 模型写出来的是半成品,有拖尾等 bug,后面的角色还把文件改坏过一次。下面照实写。本帖免费,下载区是源码包、本机补丁和中文部署说明。
4 步上手
- 装依赖:根目录
uv sync(Python 3.12),frontend下npm install。卡在 pycairo 时用包里的requirements-no-cairo.sh。 - 接 Ollama:复制
本机部署补丁/env.ollama.example为.env。再ollama create qwen2.5:7b-16k起一个 16K 上下文的别名。 - 换模型名:把
本机部署补丁/ChatDev_v1_ollama.yaml放进yaml_instance/,并打上openai_provider那个两行补丁。 - 启动:后端
server_main.py --port 6400,前端VITE_API_BASE_URL=http://127.0.0.1:6400 npx vite。打开http://127.0.0.1:5173/launch,选工作流、输需求、点启动。
它是什么
- 多智能体:多个 AI 各演一个角色,按流程轮流发言。一个写,一个挑错,一个改。
- 工作流(workflow):一份 YAML 文件,写清楚有哪些角色、谁先说、说完交给谁、循环几次。网页里能看成一张图。
- 函数调用(tool call):模型不是只回一段文字,而是喊「帮我保存文件」,由程序真的去写盘。程序员角色就是靠这个落盘。
- 自带模板:软件开发(ChatDev_v1)、游戏开发、数据可视化、深度研究、3D、教学视频等。本篇只实测 ChatDev_v1 软件开发流程,其余支持但本篇未实测。
技术栈:后端 Python 3.12 + FastAPI,前端 Vue 3 + Vite + Vue Flow。模型走 OpenAI 兼容接口,所以 Ollama、LM Studio 都能接。
本机实跑
1. 选工作流
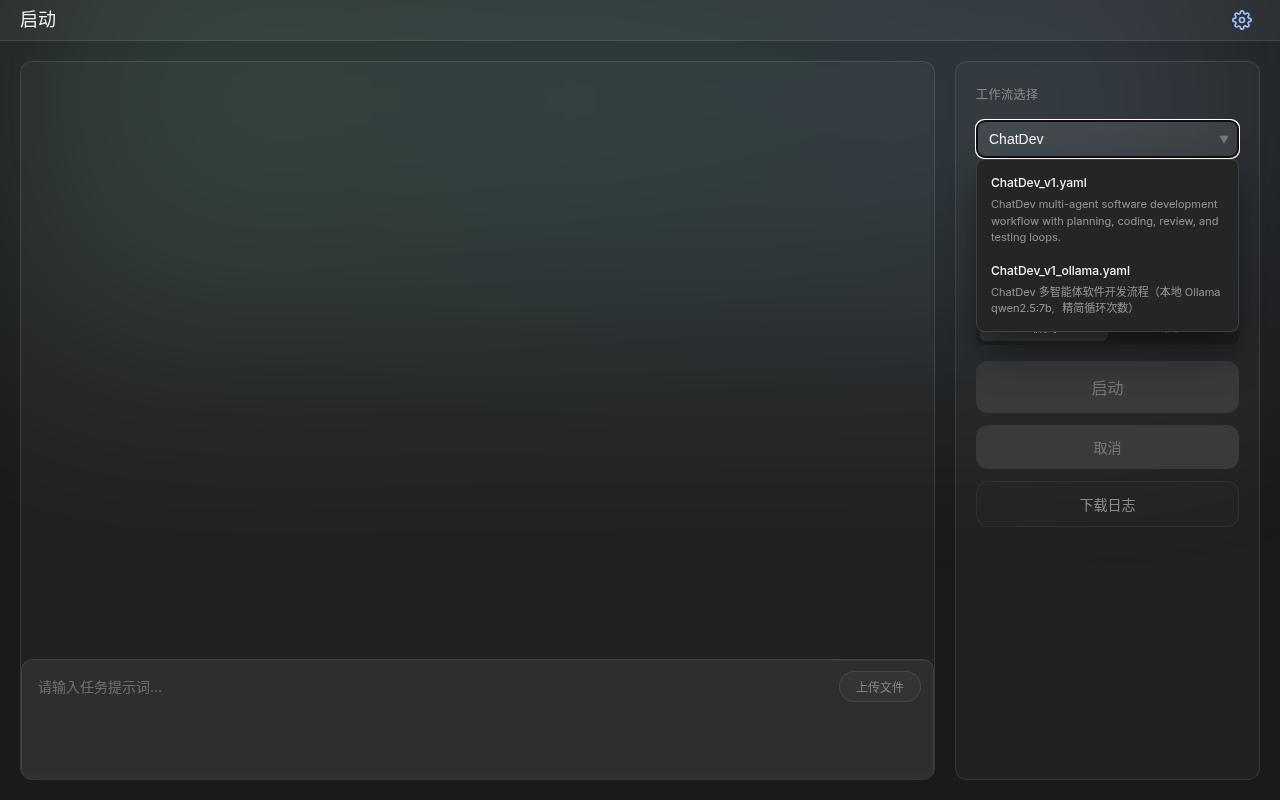
看这里:右上齿轮能切中文。「工作流选择」里输 ChatDev,能看到官方的 ChatDev_v1.yaml 和我复制改过的 ChatDev_v1_ollama.yaml。选后者。
2. 输入需求,点启动
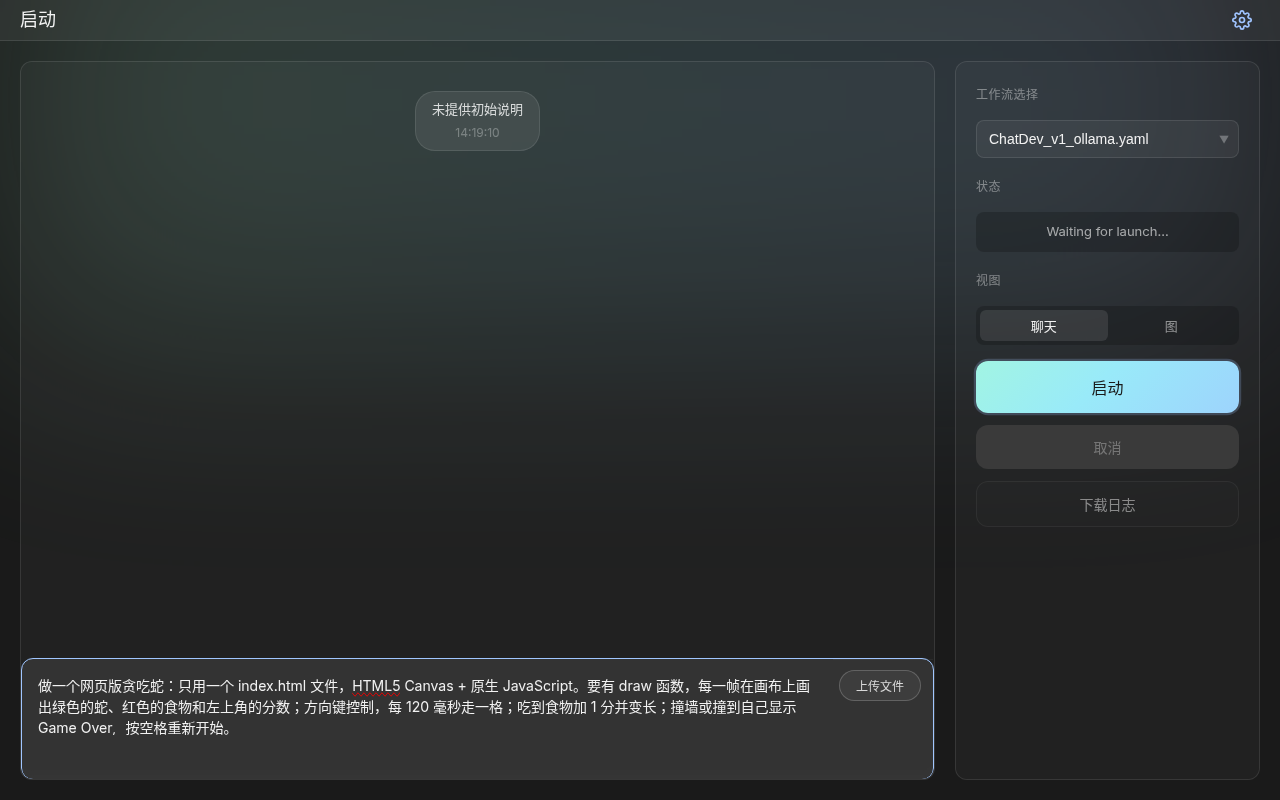
看这里:需求写得越具体越好。我写了单个 index.html、Canvas、要有 draw 函数、方向键、每 120 毫秒走一格、撞墙 Game Over。第一次只写「做个贪吃蛇」,7B 写出来的版本连画图函数都没有,只有一块黑画布。
3. 多角色对话
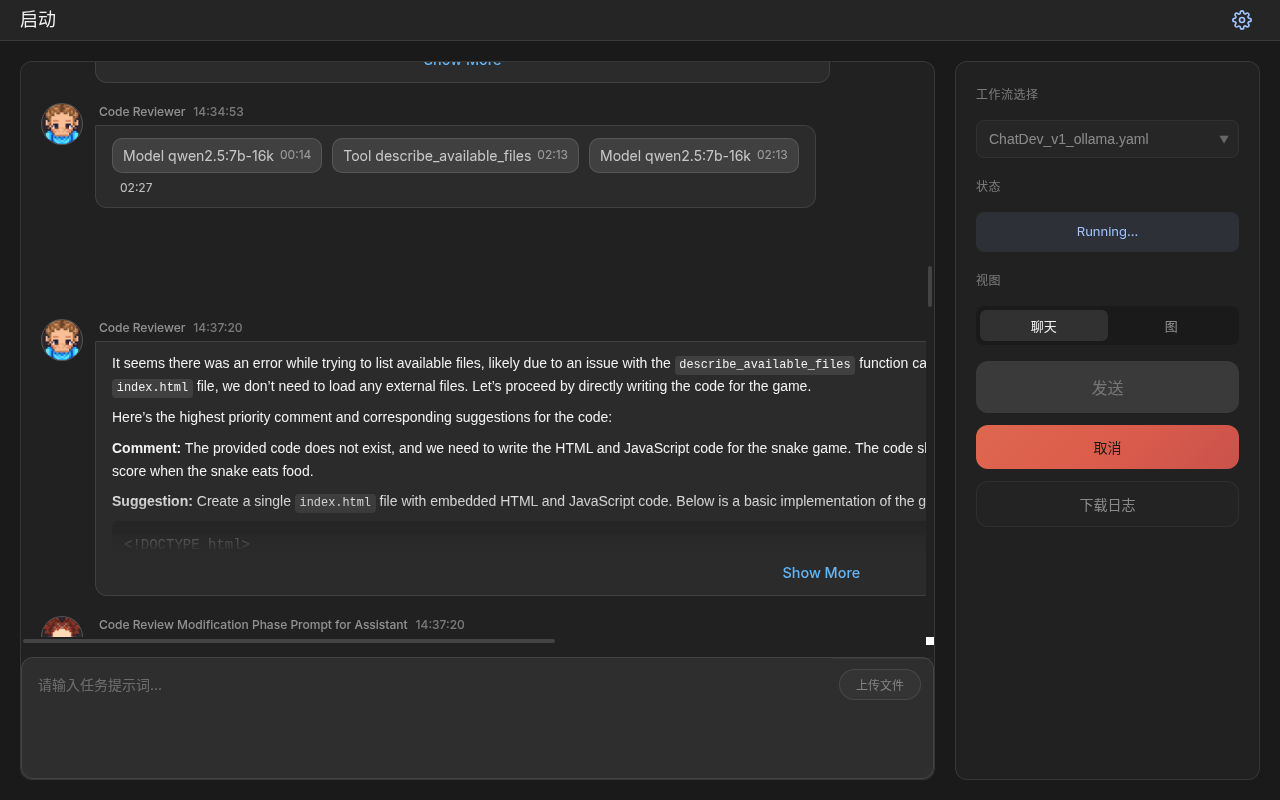
看这里:这是 Code Reviewer(代码评审)在发言。上面一排小标签是它这一轮做了什么:调了两次 qwen2.5:7b-16k,调了一次列文件工具,耗时都标在后面。下面是它给程序员的评审意见。整轮走完的角色有:程序员(编码、补全、按评审改、按测试改)、代码评审、测试工程师、产品经理(CPO)、CEO。
4. 可视化工作流画布
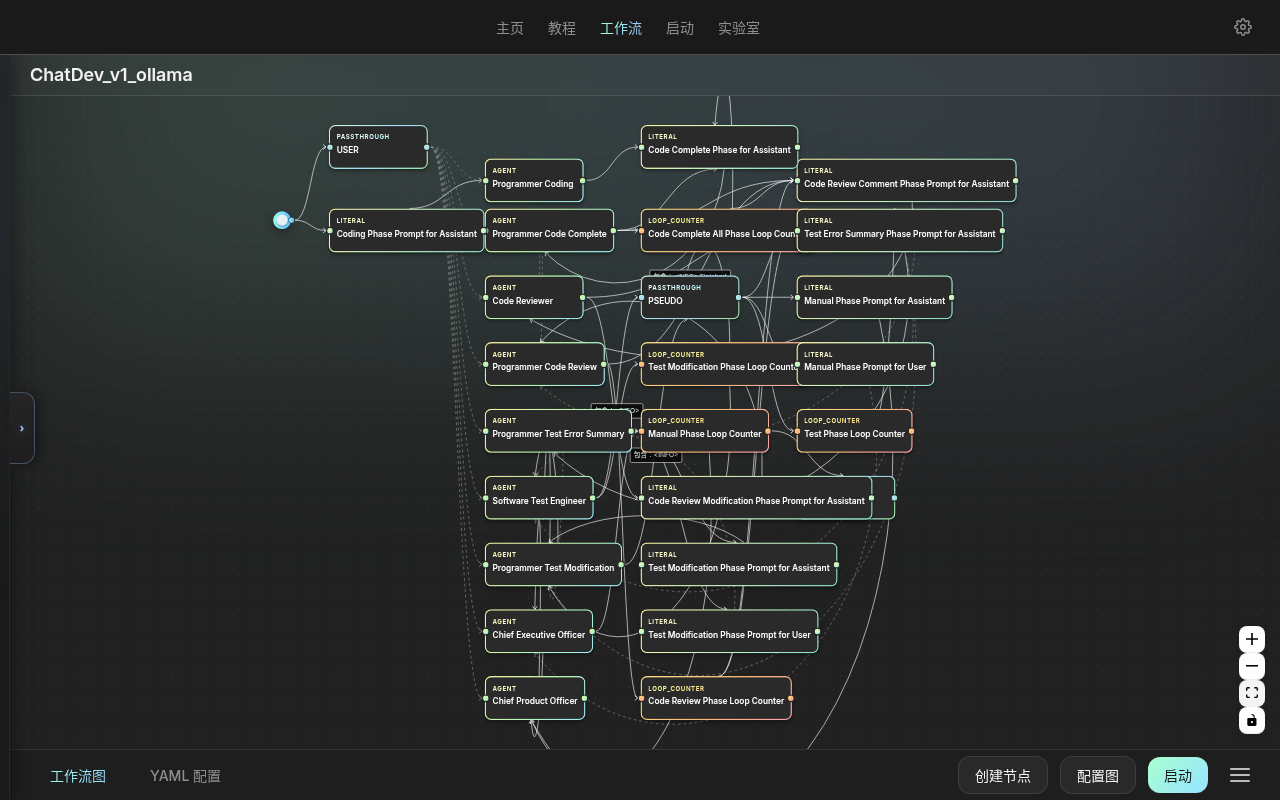
看这里:「工作流」页打开 ChatDev_v1_ollama。每个方块是一个节点:AGENT 是 AI 角色,LITERAL 是固定提示词,LOOP_COUNTER 控制循环次数。连线就是谁把话交给谁。下方「创建节点」可以自己加角色。
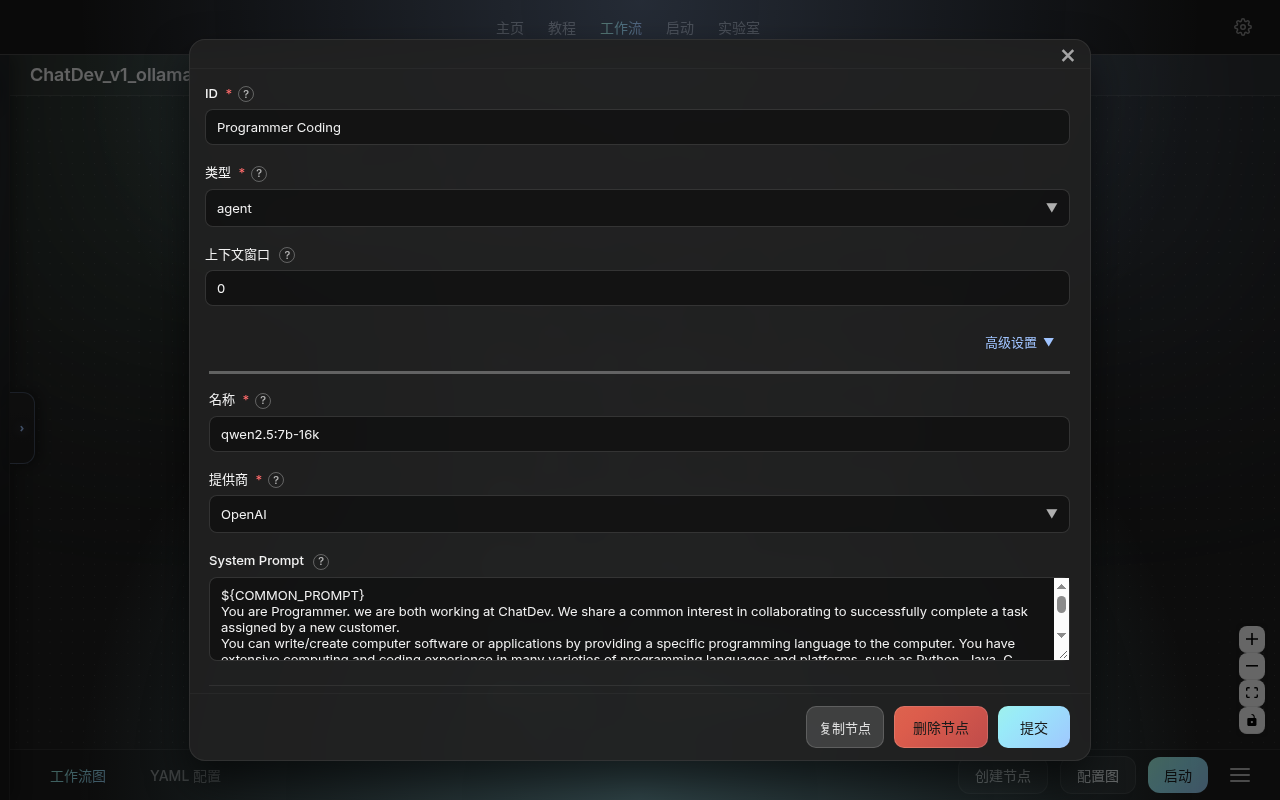
看这里:双击「Programmer Coding」节点,「名称」就是模型名,这里已是 qwen2.5:7b-16k,提供商选 OpenAI(指 OpenAI 兼容接口)。官方工作流这里写死的是 gpt-4o,不改就会去请求一个 Ollama 里没有的模型。
5. WareHouse 里的代码
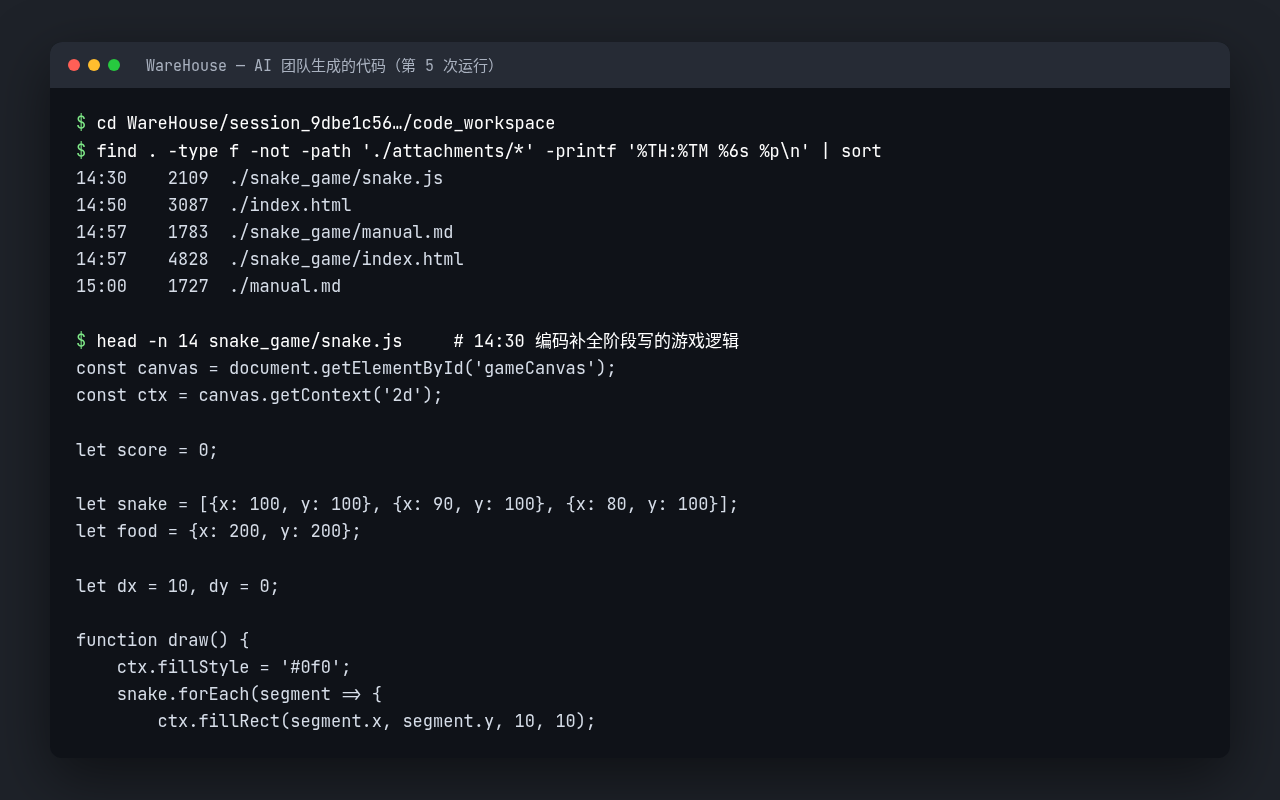
看这里:每次运行在 WareHouse/session_xxx/code_workspace/ 下生成一个文件夹。14:30 编码补全阶段写出了 snake_game/index.html 和 snake.js。后面几行是别的角色改过或新写的文件,包括两份说明书 manual.md。
6. 小游戏跑起来了
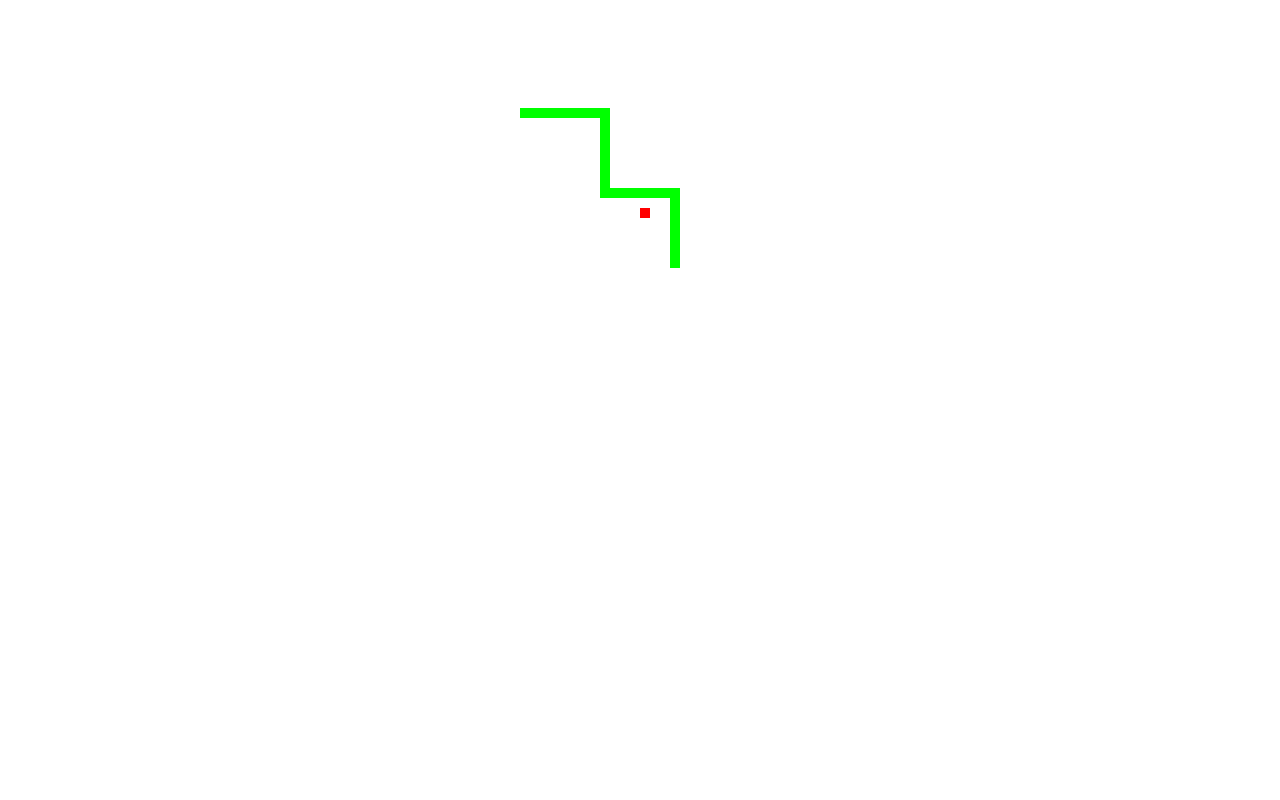
看这里:这是 14:30 那版 snake_game/ 原样在浏览器打开,我按了几次方向键。绿色是蛇,红点是食物,转向正常。我又用测试脚本把食物挪到蛇头正前方(只动数据,没改代码),蛇吃到后分数变 1、身体变长。让它一直往右走,撞墙会弹 Game Over。
AI 生成版有 bug,本篇没有人工修:
– 每一帧不清空画布,蛇走过的地方会留下绿线(就是图里的折线)。
– 样式里一句 background 把黑底盖成了白底,白色的分数就看不见了。
– 撞墙后点「取消」,提示框会一直弹。
– 流程后半段,测试修改和写说明书的角色又把 index.html 改坏了,最终版本打开只看到一堆代码文字。能玩的是中间这一版。
本地 7B 模型能力有限,一轮流程能出一个能打开、能操作的半成品。想要完整好玩的游戏,换更大的模型,或者每个阶段结束就备份产物。
7. .env 指向 Ollama
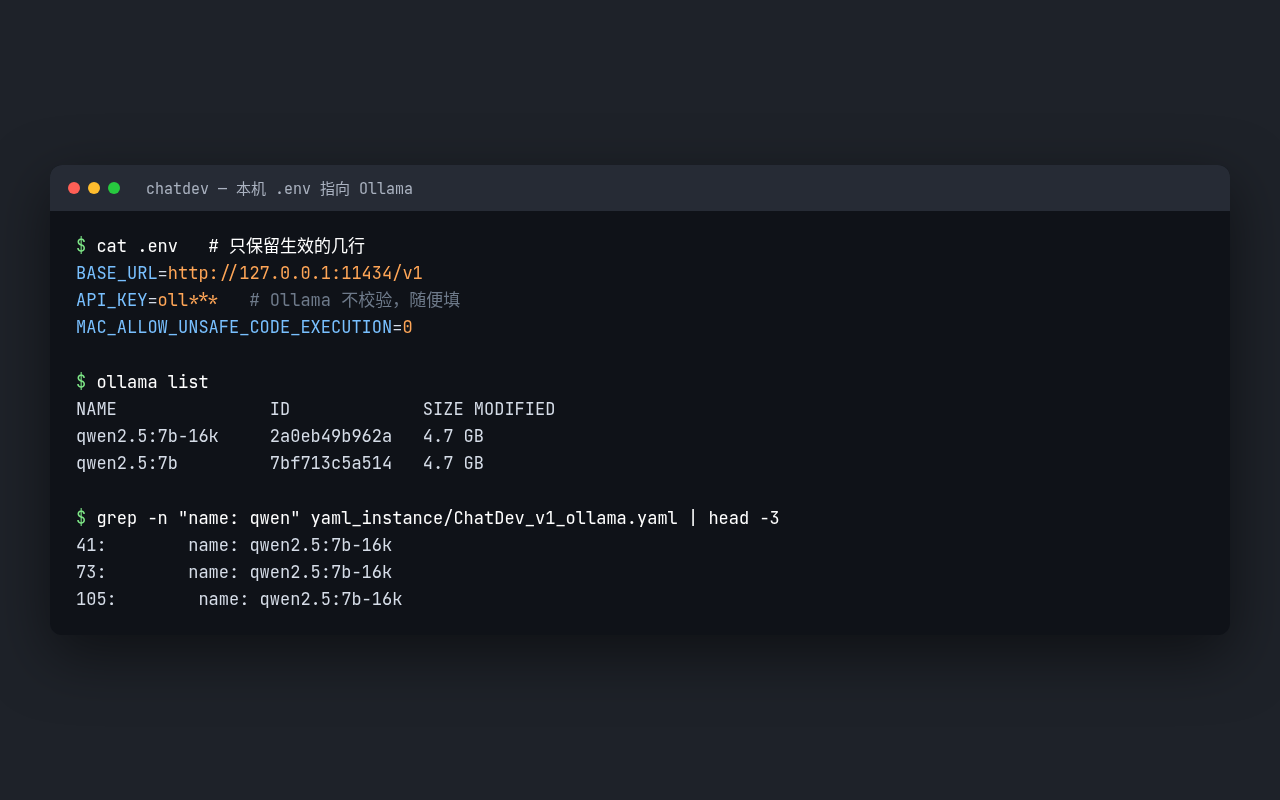
看这里:BASE_URL 指向本机 Ollama 的 /v1,API_KEY 随便填但不能空,代码执行开关保持 0。下面是 Ollama 里的两个模型:qwen2.5:7b 和我起的 16K 别名。
实测踩坑
- 模型名写死 gpt-4o:每个 agent 节点都是
name: gpt-4o、provider: openai。复制一份工作流,用 sed 换成本地模型名,或在画布里逐个双击改。 - 提示词写死 Python:ChatDev_v1 让程序员「先建 Python 虚拟环境再装包」。要做网页小游戏,得把提示词里的 Python 改成 HTML + JavaScript,并去掉装包、运行的工具。
- CPU 上 5 分钟就超时:默认请求超时 300 秒,7B 在 8 核 CPU 上一次长回答要 3~6 分钟,超时后还会自动重试,请求越排越多。在 agent 的 params 里加
timeout: 1800。运行时别开着带动画的页面抢 CPU。 - 上下文不够:系统提示词加工具说明很长,用 Modelfile 给 qwen2.5:7b 设
num_ctx 16384,起个别名就行,不用重新下载。 - 7B 会原地打转:有一次程序员把同一个文件连存了十来次,每次几分钟,默认要转满 50 轮。加
tool_loop_limit: 3限住。 - tool_loop_limit 会把流程整个搞挂:这个参数会被原样发给模型接口,报
unexpected keyword argument 'tool_loop_limit',而页面上照样显示「已完成」。包里有两行补丁,发请求前把它去掉。 - pycairo 装不上:缺 pkg-config 和 libcairo2-dev。能装系统包就装;装不了就跳过它,只影响深度研究导出 PDF。
- 循环次数调小:官方流程评审最多 10 轮、补全 5 轮。CPU 上跑不起,本篇都降到 1。一轮完整流程实测 46 分钟。
安全提醒
MAC_ALLOW_UNSAFE_CODE_EXECUTION默认 0。开成 1 后,AI 写的代码会直接在你机器上执行,这不是沙箱。只在自己的测试机临时开,测完改回 0;公网服务器上不要开。本篇全程是 0。- 前后端都没有登录,6400 和 5173 只绑 127.0.0.1,不要暴露到公网。
- 截图里的 key 是 Ollama 占位值,且已打码。包里不含任何密钥。
下载说明
免费下载源码包 chatdev-src.zip:ChatDev 2.0 主分支源码,LICENSE(Apache-2.0)原样保留。附中文 DEPLOY.txt 和「本机部署补丁」:Ollama 版工作流、改动对比、.env 示例、16K Modelfile、tool_loop_limit 补丁、跳过 pycairo 的安装脚本。为减小体积,删掉了 README 用的宣传图和演示动图,界面运行要用的图片都保留。


暂无评论内容